
300 万条事件实测:优化 SQLite 之后,我又试了 DuckDB
这两天在给自己的轻量网站统计项目 Plost 做数据库测试。有用户建议把几种数据库放到同一组数据下比较,我就先测了 SQLite 的查询与索引,再补上 DuckDB、ClickHouse 和 PostgreSQL。
测完之后,我暂时保留了这个选择:个人版默认 SQLite;DuckDB 继续作为统计分析候选;商业版沿用 PostgreSQL+ClickHouse 的分工。
DuckDB 在这组长范围统计里很快。但把当前逐事件采集逻辑直接搬过去,得到的是另一组结果。下面把两轮测试、数据和取舍一起整理出来,欢迎大家复现和交流。
测的是什么
测试时间是 2026 年 11 月 10 日至 11 日。两轮都只用了新建的临时合成数据,没有读取或修改现有实例。
- 测试机:Apple M5 Max,18 个逻辑 CPU,64 GiB 内存,macOS 27.3。是本机桌面测试,不是 VPS 测试。
- 数据量:10 万、100 万、300 万条事件,各档都覆盖 30 天,包含多个站点、重复访客和不同长度的访问。
- 表中行数指整个事件表。受测主站约占总事件的 66%,全部事件中约 90% 为 pageview;每个查询并非都扫描完整 300 万条。
- 历史时间戳是乱序的。因此,它不能代表所有按时间顺序追加的数据布局。
- 完整汇总包含访客、访问、浏览量、跳出率和访问时长五项。读取为直接 SQL,绕过应用缓存,预热一次后计时五次,取中位数;不是页面加载耗时。
下面的跨库结果是各自配置下的观测,内存预算、线程配置、客户端路径和持久性保证不同。 不能把它看成等资源条件下的通用数据库排名。
第一晚:先把 SQLite 的重复工作减少
我先比较了原始查询和改写后的查询。改写方向是把过滤后的少量必要字段组织成可复用的中间结果,再分别算访客去重、访问分组和派生指标,减少重复读取、分桶与中间结构的工作。
统计口径保持不变,访客仍在整个查询时间段内精确去重,没有把每日访客数直接相加。
300 万条事件的结果如下,单位为毫秒。[1]
| 查询 | 原始 SQL | 只改查询、不加索引 |
|---|---|---|
| 完整 30 天汇总 | 11,422.70 | 6,616.15 |
| 30 天访问趋势 | 12,175.83 | 7,287.83 |
完整汇总耗时下降约 42.1%,趋势下降约 40.1%;相同行数的数据与索引占用没有增长。
再加索引,读写和空间怎么变
我又分别试了一条较窄的表达式索引,以及一条覆盖字段更多的宽索引。它们都只建在测试库里,没有改现有实例。
下表仍然是第一晚同一轮、300 万条初始数据的比较。乱序批量写入每批 256 条,速率只计 SQL 执行时间。[1]
| 方案 | 完整 30 天汇总,ms | 乱序批写,条/秒 | 数据与索引,MiB |
|---|---|---|---|
| 只改查询 | 6,616.15 | 17,540 | 1,662.80 |
| 查询+窄索引 | 4,209.78 | 10,610 | 1,958.96 |
| 查询+宽索引 | 4,617.35 | 10,235 | 2,165.06 |
相对“只改查询”,窄索引多占约 296 MiB(17.8%),乱序批写速率下降约 39.5%;宽索引多占约 502 MiB(30.2%),乱序批写下降约 41.6%。
索引对不同报表的收益也不一样。宽索引对页面访客榜更有帮助,但并没有让所有查询都比窄索引快。
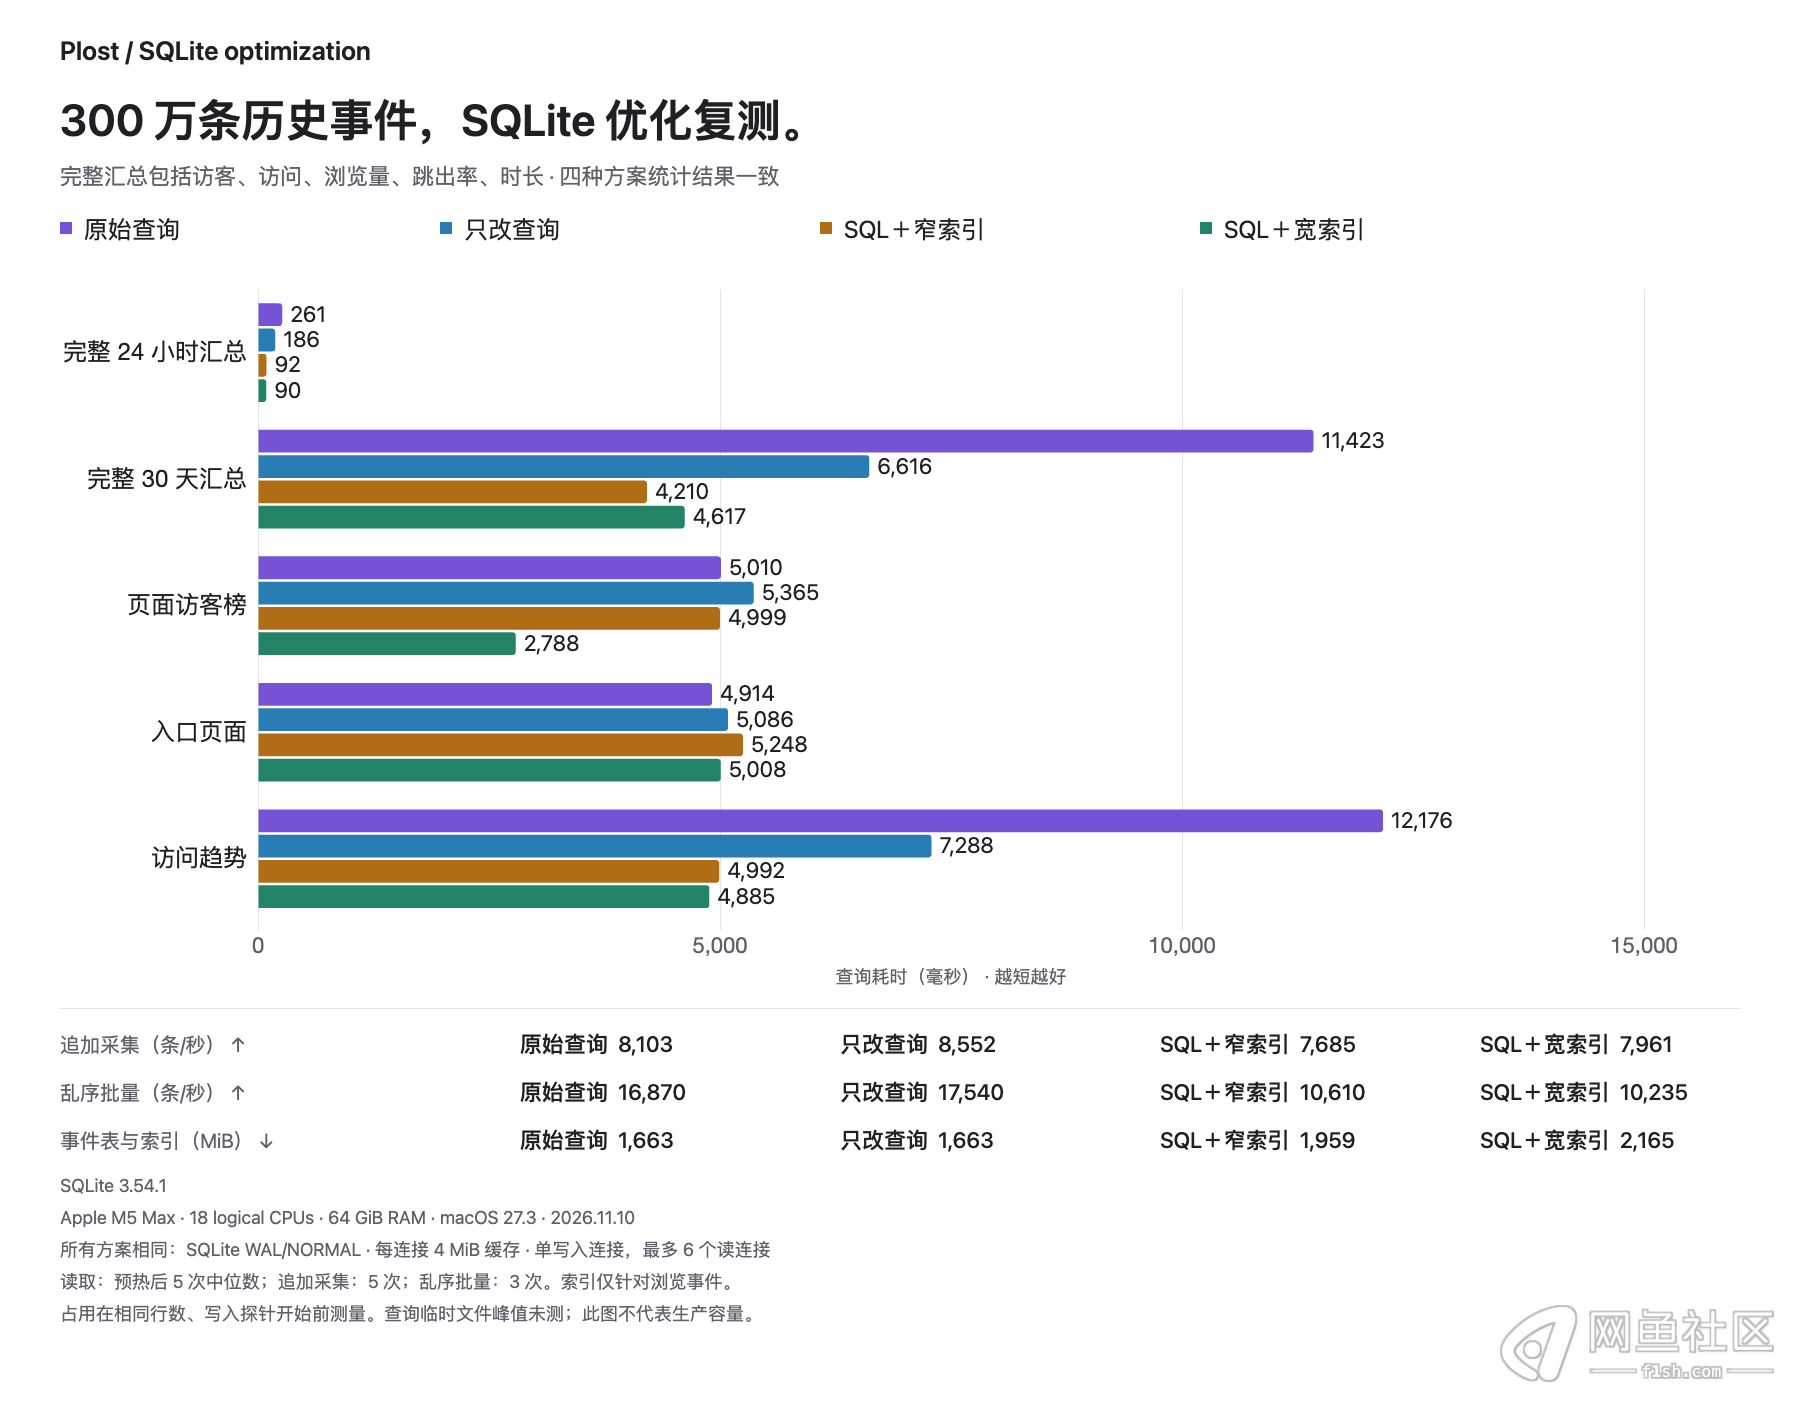
所以这轮我先在本地源码里采用了只改查询、不默认加索引的方案。读取收益已经明显,新增索引则留给有明确报表需求时再评估。
这里没有修改写入逻辑和索引,也不把“只改查询”方案独立写入时出现的波动,当作写入能力提升。
第二天:用相同数据加测 DuckDB,再对齐四库报告
这一轮生成的是相同的 27 列事件,四种数据库的输入 SHA-256 一致。五类完整报告的结果也逐项核对过:数值归一化到小数点后六位后,校验值全部一致,没有使用近似去重或预计算汇总。[2]
完整 30 天汇总的结果如下,单位为毫秒:
| 初始事件总量 | SQLite(已优化) | DuckDB | ClickHouse | PostgreSQL |
|---|---|---|---|---|
| 10 万 | 114.12 | 4.56 | 10.85 | 32.09 |
| 100 万 | 1,677.73 | 12.34 | 26.22 | 779.25 |
| 300 万 | 6,278.20 | 28.74 | 62.16 | 2,785.61 |
表中 DuckDB 和 ClickHouse 的查询线程上限是 6。PostgreSQL 由执行计划自动选择并行,每个 gather 最多 6 个 worker;这不等于四个引擎都用了相同数量的 CPU。
DuckDB 单线程也补测了:300 万条下,完整 30 天汇总约 111.95 ms。所以这组数据上,它的统计查询优势不只来自线程数量。
这一轮 SQLite 的汇总约 6.28 秒,前一晚“只改查询”约 6.62 秒。两者来自不同轮次,不把这点差异算成又一次优化收益。
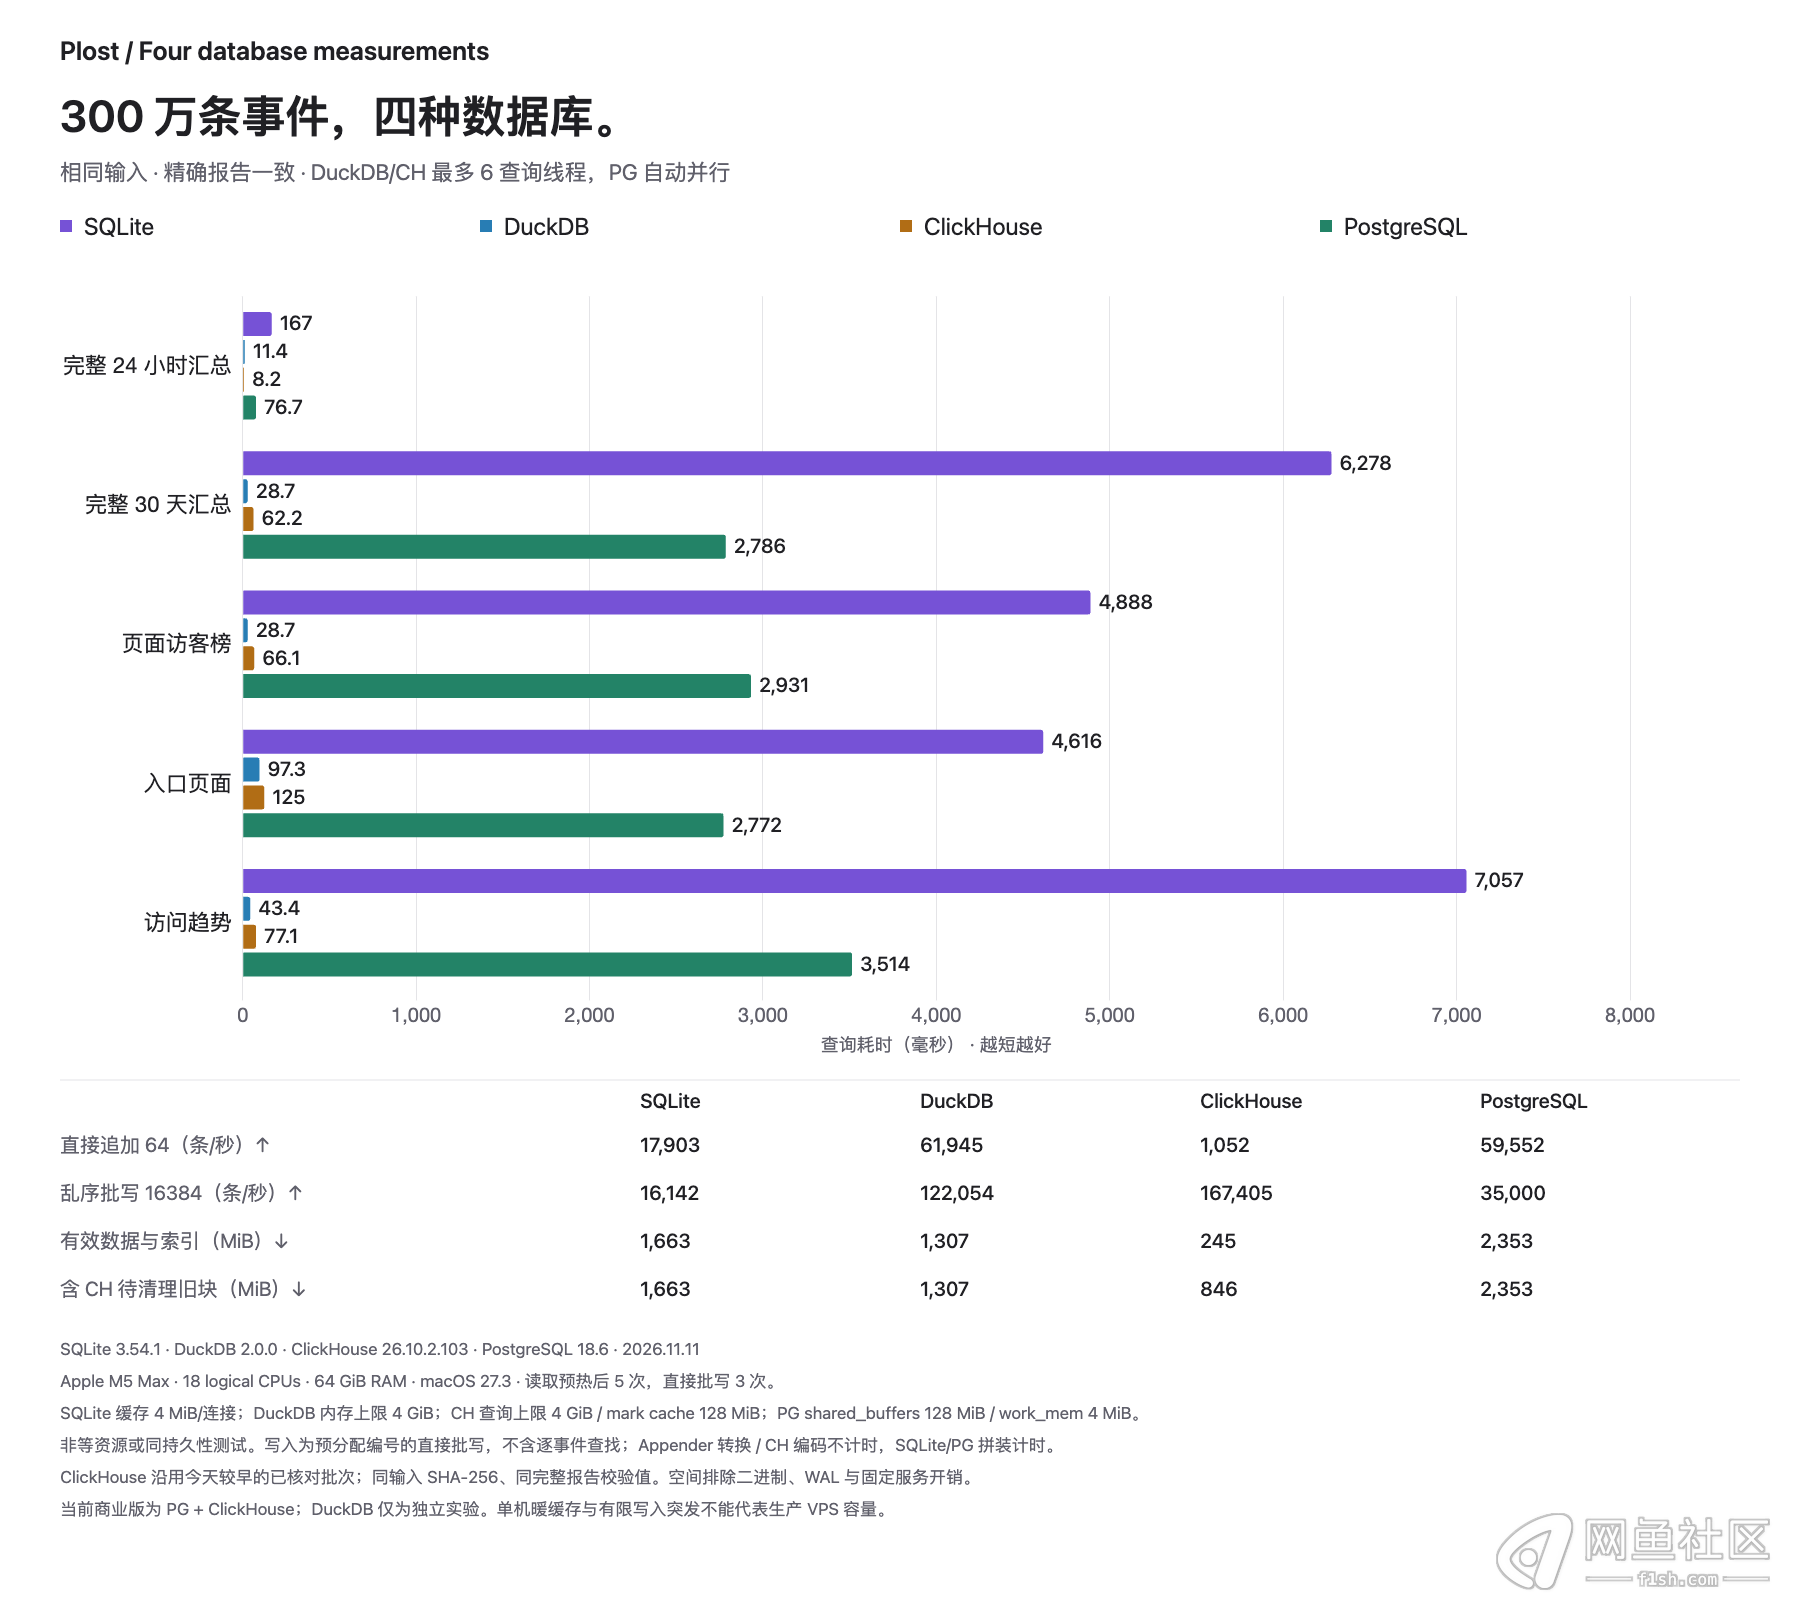
ClickHouse 沿用了较早完成、在 11 月 11 日结束的那组测量,再次核对了相同输入和完整报告结果;PostgreSQL 则按完整五项汇总重新测过。没有拿旧的三字段 overview 混进这张表。
查询快,接到当前采集路径上表现怎样
这部分是我更关心的。
目前 Go 版采集事件时,每条新事件会先查询它所属的访问,再执行插入。因此我把两种写入分开测:一种保留这套逐事件操作结构;另一种提前分配好编号,直接批量写入。DuckDB 的直接批写使用 Appender。
这轮两种方式的事件和编号都在计时前准备;采集式路径还会根据查找结果续接访问编号。这里只保留 SQL 操作结构,不是完整采集接口。
下面均为 300 万条初始数据,单位是条/秒,取三个有限样本的中位数。[3]
| 写入方式 | SQLite | DuckDB |
|---|---|---|
| 逐事件查找+INSERT,每批 64 提交 | 9,560 | 1,027 |
| 预分配编号,直接追加批写 256 条 | 17,051 | 144,765 |
| 预分配编号,直接追加批写 16,384 条 | 20,385 | 133,253 |
逐事件采集式测试每个样本是 512 条事件;直接批量 256 的每个样本是 8,192 条,批量 16,384 的每个样本是 32,768 条。
事件生成都在计时外,不含 HTTP、GeoIP 和完整采集队列。直接批写中,DuckDB 的值转换在计时外,SQLite 的参数与 SQL 拼装仍在计时内。因此这些数字也不能当作纯引擎性能或接口最大容量。
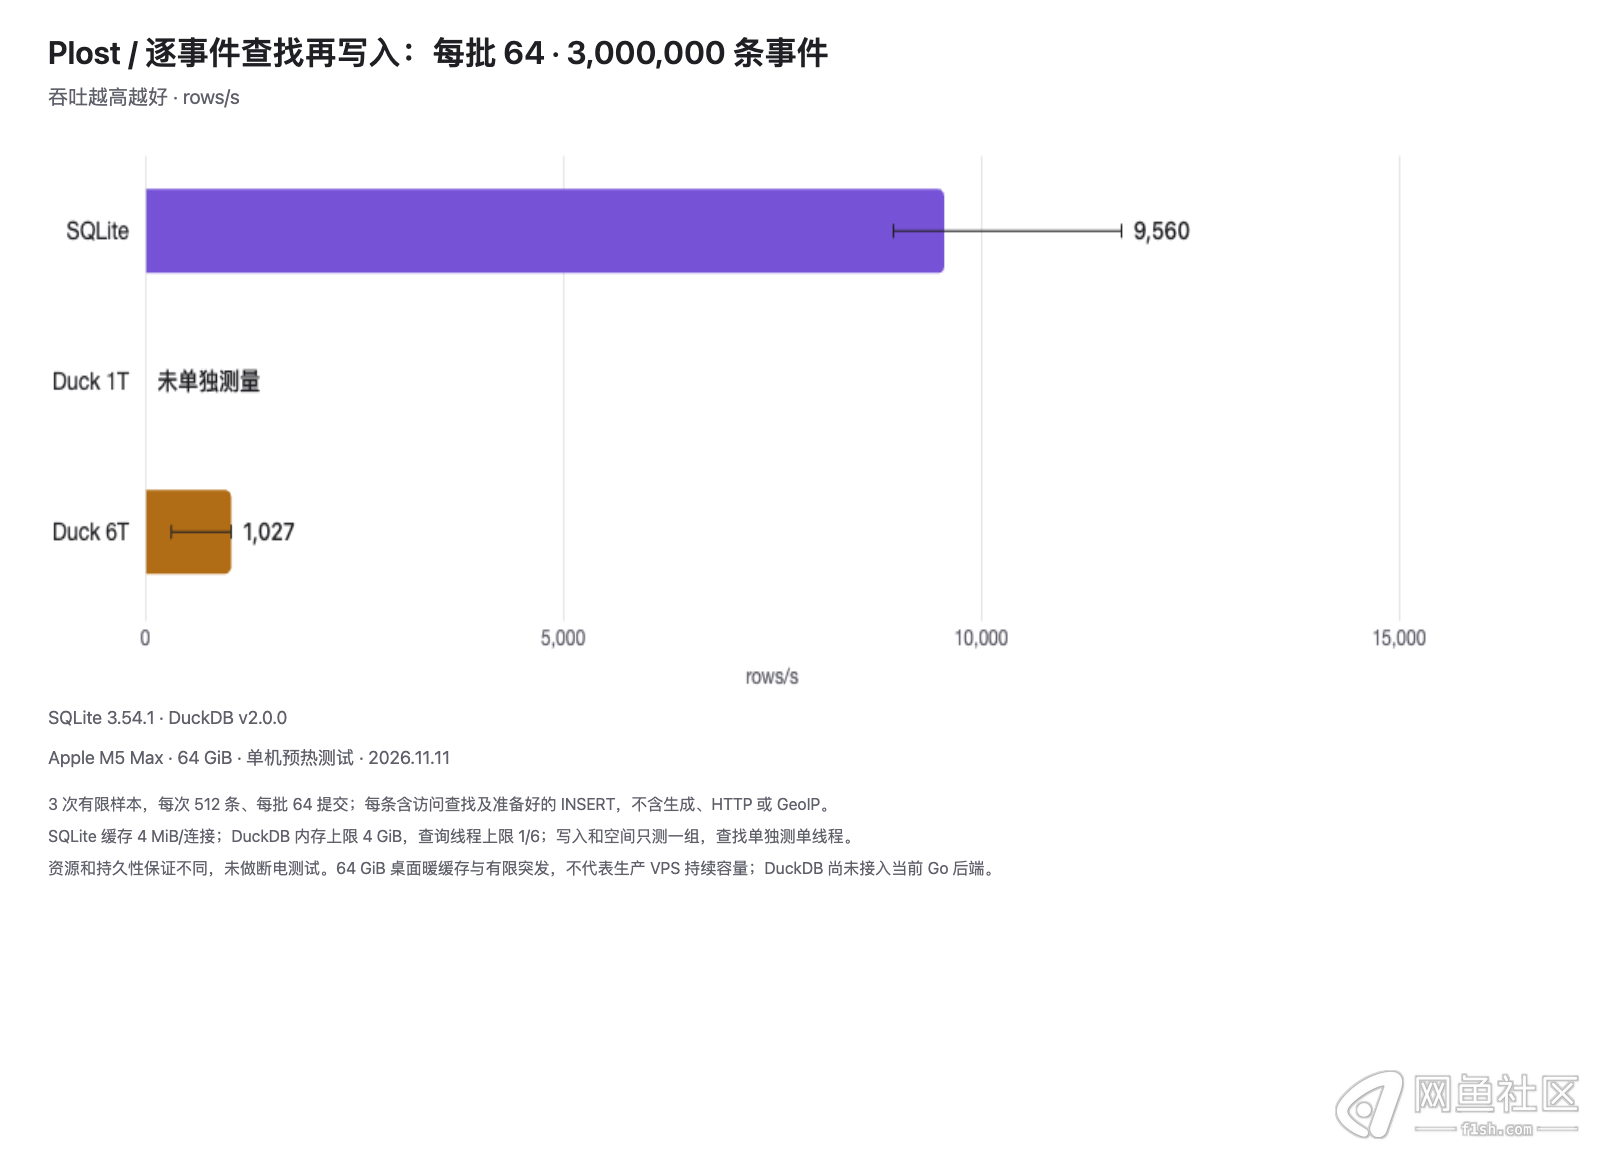
结果支持两个判断:DuckDB 很适合这组统计查询与直接批写;按当前逐事件查找再 INSERT 的实现,SQLite 的采集式表现更好。 要兑现 Appender 的吞吐收益,需要采集链路真正采用适合它的批量方式。
我还针对 300 万条数据补了一个 DuckDB 单列访客查找索引探针。这条 SQL 的 EXPLAIN 仍显示顺序扫描,采集式结果约 1,000 条/秒,没有明显改善。它只说明这组 SQL 和索引组合没有获益,不能据此认定 DuckDB 没有优化空间;改写查询、专用会话表等方案仍可继续验证。
还有一点需要分清:两晚的写入测试方法不同。 前一晚采集式写入包含合成事件生成,批量速率只计 SQL;第二天生成在计时外,样本数量与写入路径也不同。所以两轮写速率分别解读,不把“8,552 到 9,560 条/秒”当作一次性能提升。
空间也要看具体统计范围
第二轮、相同 300 万条初始数据,SQLite 的数据与索引约 1,662.80 MiB,DuckDB 约 1,306.76 MiB,PostgreSQL 事件表与索引等约 2,353.07 MiB。[2]
ClickHouse 的有效压缩数据块约 244.96 MiB,但把采样时等待清理的旧数据块也算上,是约 846.36 MiB。因此不能把“有效数据块 245 MiB”写成“整个服务只占 245 MiB”。
这些口径都排除了二进制、WAL、固定服务开销和峰值临时空间;各引擎的原生存储结构也不同。MiB 按 1,048,576 字节计算。
测试条件中,影响解读的几项
- SQLite:3.54.1,使用项目的 modernc Go 驱动,WAL/NORMAL,每连接缓存 4 MiB,最多 6 个读连接、1 个写连接。6 个读连接不等于一条 SQL 使用 6 核并行。
- DuckDB:2.0.0,官方 Go 驱动,内存上限 4 GiB,分别测 1/6 查询线程。主测试保留 id 主键、对应字段组合的四个全索引与 source 唯一表达式索引;它们不等同于 SQLite 的部分索引。
- ClickHouse:26.10.2.103,MergeTree、月分区、按站点/时间/id 排序;查询内存上限 4 GiB、服务上限 8 GiB、mark cache 128 MiB。同步批写,未开启 async_insert;两个插入 fsync 选项为 0。排序键不强制唯一,不能当作与其他库完全相同的事务/去重语义。
- PostgreSQL:18.6,shared_buffers 128 MiB、work_mem 4 MiB,fsync 与 synchronous_commit 开启。初始加载用 COPY,计时写入用多行 INSERT;没有把初始 COPY 当成写入成绩。
四库直接批写中,DuckDB Appender 值转换与 ClickHouse JSON 编码在计时外,SQLite/PostgreSQL 的 SQL 拼装仍计时。客户端路径和掉电保证没有统一校准,不能只拿一个吞吐数就认定引擎优劣。
这次没有测低内存 VPS、冷缓存、长期饱和并发、远程网络或断电恢复。DuckDB 的内存上限也不等于实际 RSS;附件中的缓冲区诊断值不能直接当作整个进程占用。
今天 10 万条的个人版测试,因初始检查与第一轮开头重叠而完整重测了一次,选用后测值,两轮原始记录都保留;100 万和 300 万使用首个完整轮次。
我目前的选择
个人版继续以 SQLite 为默认。现有采集路径、单文件部署、备份恢复和跨平台构建都围绕它运行,当前的查询改写也已经带来收益。DuckDB 暂时保留为长范围分析或批量采集的候选,先验证完整链路,再决定是否接入。
商业版当前源码已经采用 PostgreSQL 管账号、团队、站点和权限,ClickHouse 管事件统计的分工。本次单机 SQL 实验没有验证多租户、持续负载或扩容能力,我也没有仅凭这组聚合查询成绩更换商业版架构。
后续更值得做的是,把 DuckDB 的批量采集和会话处理方案做完整,再到目标规格的 VPS 上测持续读写、资源占用与故障恢复。欢迎大家基于相同数据和口径提出优化建议。
原始数据与复现
附件中的数据来源:
- [1] SQLite 优化与索引实验:
sqlite-2026-11-10/results.json、results.jsonl,另附候选索引和查询差异。 - [2] 四库对比:
four-db-2026-11-11/four-engines.json,以及 PostgreSQL 新测、ClickHouse 沿用轮次的原始 JSONL。 - [3] 个人版 SQLite/DuckDB:
four-db-2026-11-11/results.json、results.jsonl,另附首次/重测记录、原生查找索引探针与诊断文件。
复现工具在 source/tools/dbbench/。所有样本都来自合成数据,附件不含真实事件、现有数据库、连接凭据或服务日志。
鱼是摸不完的,我们要尊重梦想。